AIに音楽の生成を指示するには、大きく分けて、音源の生成を指示する方法と、楽譜の生成を指示する方法のふたつがあります。
一般に音楽生成と言う言葉でイメージされるのは、前者の方が多いでしょう。「今夜は彼女といいムードで飲みたいから、静かでジャジーな感じの女性ボーカルの曲を一曲作って」というような指示で作らせて、その曲を聴きながら乾杯するというような使い方です。楽譜を作る方法を用いている人はあまり多くないかもしれませんが、自分で演奏したい場合やいろいろ編曲したい場合には、こちらの方が向いています。
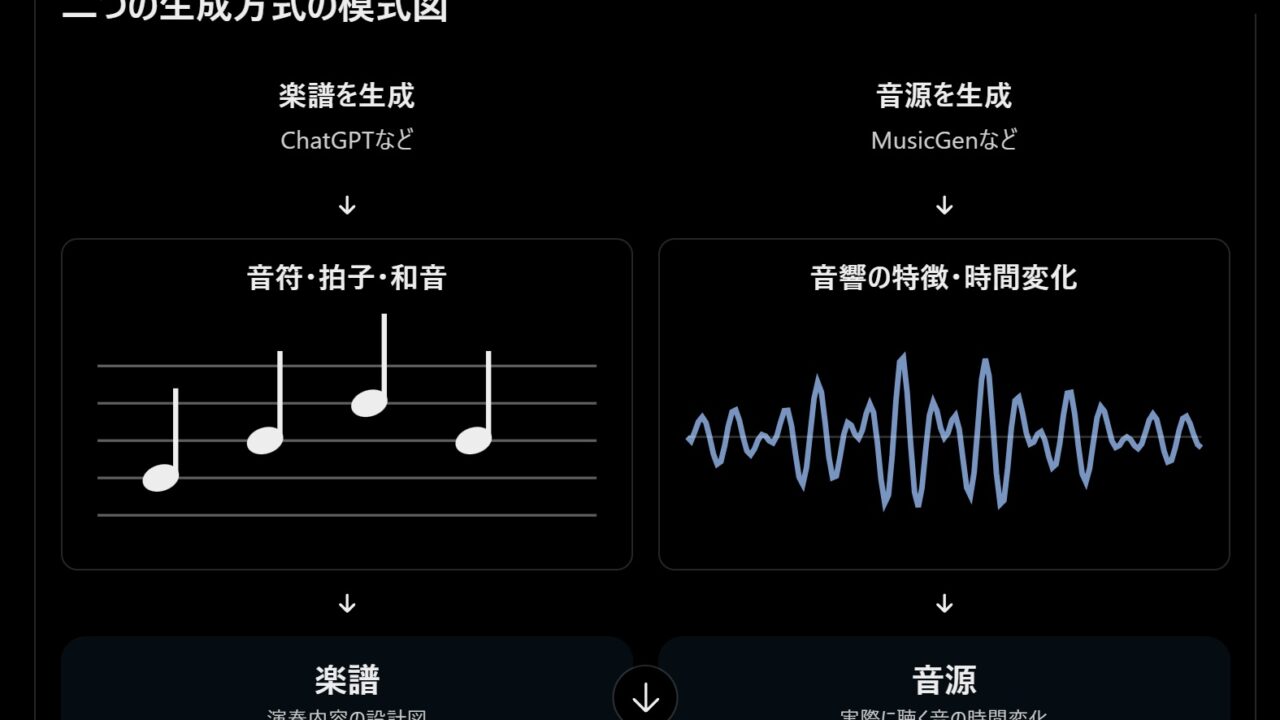
二つの違いをまとめると、大体次のようになります。
まず、音源生成の場合は、例えばMusicGenというAIでは、音楽の録音を圧縮した音響トークンというデータを扱い、大量の音響トークンの関係から、新しいトークン列を生成し、それを音声波形に変換します。旋律、和声、リズム、音色、発音のニュアンス、残響などが、相互に関連した音響情報として生成されるので、音色や響き、演奏の微妙な表情まで一度に作れる利点があります。しかしその反面、特定の音符や和音だけを取り出して正確に修正するということは難しい場合があります。
これに対し、ChatGPTなどを使って楽譜を生成する場合は、音符や休符、拍子、和音といった記号を組み合わせて音楽を作ります。例えば「4分の3拍子で8小節のワルツを作って」と頼むと、拍子や音階、和音の関係などを考慮して、旋律を組み立てます。楽譜生成では、一つひとつの音符や和音、曲全体の構成を確認しながら、細かく修正することが可能ですが、演奏の豊かな表情など(たとえば、ヴァイオリンの細かなビブラート、歌声の表情等)は表現しにくくなります。
簡単に言うと、音源生成は音楽の響きを直接作り、楽譜生成は音符和音拍子などの要素から音楽の構造を作るわけですが、この二種は人間が作曲する場合とかなり似ています。人間の場合も、メロディが頭の中に湧いて来てそれを元に作曲する場合と、音の並びをいろいろ頭で考えて組み立てていく場合と、両方があると思います。人間の場合、そのどちらか一方だけという人は少なく、両方の作り方をある程度併用しながら作曲することが多いのではないでしょうか。AIの場合も、両方の作り方を組み合わせて何度も行き来することで、より豊かな作品を目指せる可能性がありそうです。